Когато един AI node вече не стига
В предишни ръководства изградихме 24/7 AI agent сървър с ClawBrain (IWILL N1522), пуснахме множество асистенти на един Mini PC с Proxmox и разгледахме как Hermes Agent и Buzz превръщат тези машини в работещ agent workspace.
Всички тези сценарии обаче имат обща зависимост: самият модел работи някъде другаде. Агентът е ваш, паметта му е ваша, но разсъждението се случва зад чужд API ключ и се заплаща на токен.
В един момент това спира да работи — защото данните не бива да напускат компанията, защото месечната сметка за токени надхвърли цената на хардуер, или защото искате да дообучите модел върху собствени документи. Тогава разговорът се мести от Mini PC към GPU сървър в собствената ви сървърна стая.
Това ръководство е за практическата страна на този преход: как се избира шаси за GPU/AI сървър, какво реално ограничава броя карти, защо захранването и охлаждането са по-важни от името на видеокартата и кои модели IWILL покриват кой сценарий.
Какво ще научите:
- Кога on-prem GPU сървърът се изплаща спрямо облачни GPU часове
- Как да сметнете нуждата си във VRAM, а не в брой карти
- Какво определя реалния капацитет на шасито — слотове, дължина, захранване, въздух
- Разликата между 4U, 5U, 7U и 9U при GPU сървър
- Кога barebone шаси с BMC е по-доброто решение от празно шаси
- Кога въздушното охлаждане отстъпва на течното
Четирите причини да преместите AI натоварването при себе си
Данните остават вътре
Договори, медицински данни, чертежи, клиентска кореспонденция. Когато обработката им изисква изрично основание, най-чистият отговор е моделът да работи в същата мрежа, в която живеят данните — без изходящ трафик към външен доставчик.
Предвидима цена при постоянно натоварване
Токените се таксуват на използване. Ако натоварването е постоянно — индексиране, класификация, вътрешен асистент за целия екип — сметката расте всеки месец, докато хардуерът се плаща веднъж и после струва само ток.
Fine-tuning върху собствени данни
Дообучаването на модел върху вашата документация и терминология е най-директният начин да стане полезен за вашия бизнес. Това изисква GPU време в големи количества — сценарий, в който собственият хардуер се изплаща най-бързо.
Независимост от доставчика
Моделите се пенсионират, цените се променят, условията за ползване се обновяват. Локално внедреният модел продължава да работи по същия начин и след година — важно, когато сте вградили AI в производствен процес.
Честната обратна страна: собственият GPU сървър означава и собствена отговорност — захранване, охлаждане, резервни части, обновявания. При спорадично натоварване облачните GPU часове почти винаги излизат по-евтино. Преходът има смисъл, когато натоварването е постоянно или когато данните не могат да напуснат мрежата.
Първо решение: колко видео памет ви трябва
Най-честата грешка при планиране е да се започне от броя карти. Правилната отправна точка е общата видео памет (VRAM), защото тя определя кой модел изобщо може да се зареди. Скоростта идва след това.
Три въпроса определят сметката:
Инференция или обучение?
Обучението и fine-tuning изискват в пъти повече памет от инференцията за същия модел, защото освен теглата се пазят градиенти и състояние на оптимизатора. Сървър, проектиран само за инференция, обикновено не е достатъчен, когато решите да тренирате.
Колко големи са моделите, които искате да ползвате?
Размерът на модела в параметри и избраната квантизация определят колко VRAM заема. Квантизацията сваля изискването значително срещу малка загуба на качество — затова един и същ модел може да се побере на една карта или да изисква няколко.
Колко едновременни заявки ще обслужвате?
Един вътрешен асистент за петима души и inference endpoint за цялата компания са различни машини. Паралелните заявки заемат допълнителна памет за контекста на всяка сесия.
Практическо правило: заложете шаси с капацитет поне два пъти по-голям от днешната ви нужда. Смяната на видеокартите е въпрос на един следобед; смяната на шасито означава нов сървър. Именно затова разликата между шаси за 5 и за 10 карти е по-важно решение от избора на конкретния модел карта.
Какво реално ограничава броя карти в шасито
„Поддържа 8 GPU“ не е едно число, а резултат от четири независими ограничения. Ако някое от тях не е покрито, картите просто няма да влязат — или ще влязат и ще тротлират.
Ширина на слота, не брой слотове
Съвременните карти заемат 2, 2.5, 3 или 3.5 слота заради охладителя. Шаси с 11 PCIe слота не побира 11 карти. Затова спецификациите се четат буквално: G4830-P4 указва 10 карти с двойна ширина, а G9780-P4 — 10 карти с ширина 3.5 слота. Това са различни шасита за различни карти.
Дължина на картата
Ограничението е физическо и безкомпромисно. G4830-P4 приема карти до 270mm, докато G4835-P4 и G9780-P4 — до 350mm. Разликата от 80mm решава дали конкретен модел карта изобщо влиза в сървъра. Измерете реалната карта, а не каталожната ѝ дължина.
Захранване и резервиране
Осем карти под натоварване плюс процесори и дискове изискват сериозна мощност и стабилни шини. Затова GPU шаситата ползват CRPS модули: G4830-P4 и G9780-P4 работят с 4+1 резервиране, F-G587-H12-A8 поддържа до 4 модула в 3+1 режим с опция 3200W, а F-G791-H12-A8 стига до 8 модула в 4+4 режим, захранващи дънната платка и картите поотделно.
Въздушен поток през картите
Плътно наредени карти се задушават взаимно. Решението е висок статичен натиск — вентилатори, които бутат въздух през тясното пространство между охладителите. G4830-P4 комбинира три 120mm позиции отпред с три 80mm и два 60mm отзад; G9780-P4 разчита на 12 позиции за 120mm вентилатори; barebone моделите използват 8 високопроизводителни вентилатора N080.
4U, 5U, 7U или 9U: какво печелите с всеки сантиметър
U-размерът е компромис между плътност и охлаждане. Ако плащате за място в колокация, всеки U има цена. Ако сървърът стои във ваша стая, по-високото шаси обикновено е по-спокойното решение.
| Формат | Модел | GPU | Силна страна |
|---|---|---|---|
| 4U | G4835-P4 | 5 × 3.5 слота, до 350mm | Начална конфигурация с място за растеж |
| 4U | G4830-P4 | 10 × двойна ширина, до 270mm | Максимална плътност в 4U |
| 4U | G465-12 | GPU + 12 × 3.5" hot-swap | Когато данните стоят при модела |
| 5U | F-G587-H12-A8 | 8 GPU, barebone | Готова платформа с BMC и 32 DDR5 слота |
| 7U | F-G791-H12-A8 | 8 × full-length | Дълги карти и 4+4 захранване |
| 9U | G9780-P4 | 10 × 3.5 слота, до 350mm | Инференция с максимален въздушен обем |
Обърнете внимание на G465-12: това е единственият ред в таблицата, който решава друг проблем. Той комбинира GPU капацитет с 12 позиции за 3.5" дискове и 12Gb/s MINI SAS backplane — конфигурация за случаите, в които наборът от данни за обучение или векторната база трябва да живеят в същата машина, вместо да се теглят по мрежата при всяко зареждане.
Barebone платформа или празно шаси?
Barebone платформа
F-G587-H12-A8 · F-G791-H12-A8
Шасито идва с дънна платка, захранвания, охлаждане и BMC като съгласувана платформа. Добавяте процесори, памет, дискове и карти.
- •До 32 DDR5 DIMM слота (4400/4800/5600MHz)
- •Вграден BMC AST2600 — IPMI 2.0 и Redfish
- •21 MCIO 5.0 интерфейса за 10G/25G/40G карти
- •OCP 3.0 порт и отделен management порт
- •Съвместимост, потвърдена от производителя
Празно шаси
G4835-P4 · G4830-P4 · G465 серия
Вие избирате дънната платка, захранването и охлаждането. Повече свобода и обикновено по-ниска начална цена — срещу повече работа по съгласуването.
- •Дънни платки до 12"×13" (E-ATX/ATX)
- •Изискване: 5 × PCIe 4.0 x16 или 10 × x8 слота
- •Свободен избор на CRPS или ATX захранване
- •BMC зависи от избраната дънна платка
- •Съгласуването на компонентите е ваша задача
Кое кога: ако сървърът ще работи в производствена среда и няма кой да го поддържа на място всеки ден, barebone платформата с BMC се изплаща още при първото дистанционно рестартиране. Ако имате екип, който сглобява и поддържа хардуер, празното шаси дава повече машина за същия бюджет.
Охлаждане: къде въздухът спира да стига
GPU сървърът е преди всичко топлинен проблем. Картите работят при пълно натоварване с часове или дни, а не на пикове от по няколко секунди. Ако въздушният поток не е достатъчен, картите свалят честотите си и обучението, за което сте платили, просто отнема повече време.
Въздушното охлаждане покрива повечето сценарии — при условие че шасито е проектирано за висок статичен натиск и че сървърната стая има реален капацитет да изведе топлината. Течното охлаждане става смислено в три случая:
- Висока плътност — когато максималният брой карти работи едновременно и постоянно;
- Шум — когато сървърът не е в изолирана стая, а вентилаторите с висок статичен натиск са силни;
- Ограничение на средата — когато климатизацията на помещението не може да поеме допълнителния топлинен товар.
От серията с течно охлаждане Y-G587-H12-A8 покрива до 8 карти от класа RTX 4090/5090, A100, H100 и H200, с външна система с разделяне на студения и горещия поток и тръби 1" или 0.75". Поддържа до 12 позиции за 2.5"/3.5" дискове, 32 DDR5 слота и CRPS захранвания в 3+1 режим с опции 2000W и 3700W.
Преди да поръчате: проверете три числа за помещението — наличната мощност на захранващата линия, капацитета на климатизацията в kW и дълбочината на rack-а. Шасита като G4830-P4 и G9780-P4 са дълги над 630mm и не влизат в плитък rack.
GPU сървърът е и мрежов актив
Машина, на която живеят моделите и данните за обучение, е сред най-чувствителните активи в мрежата. Тя има BMC с пълен контрол над хардуера, често отворен inference endpoint и достъп до вътрешни хранилища.
Затова същите правила, които разгледахме в ClawFirewall за Self-Hosted и Hybrid AI, важат в двойна степен тук:
- BMC портът никога не гледа към интернет — отделен management VLAN, достъпен само през VPN;
- Egress filtering — сървърът, който държи данните ви, няма причина да инициира произволен изходящ трафик;
- Сегментация — inference endpoint-ът се публикува само към мрежите, които наистина го ползват.
За организациите в обхвата на NIS2 това не е препоръка, а част от изискванията за управление на риска — локалната обработка на данни решава един проблем, но създава нов периметър, който трябва да бъде документиран и защитен.
Три отправни точки според сценария
Изборът се свежда до един въпрос: докъде искате да можете да растете, без да сменяте шасито. Трите модела по-долу покриват трите типични начални точки — първи сървър за екип, плътна конфигурация за постоянна инференция и готова платформа за производствена среда.
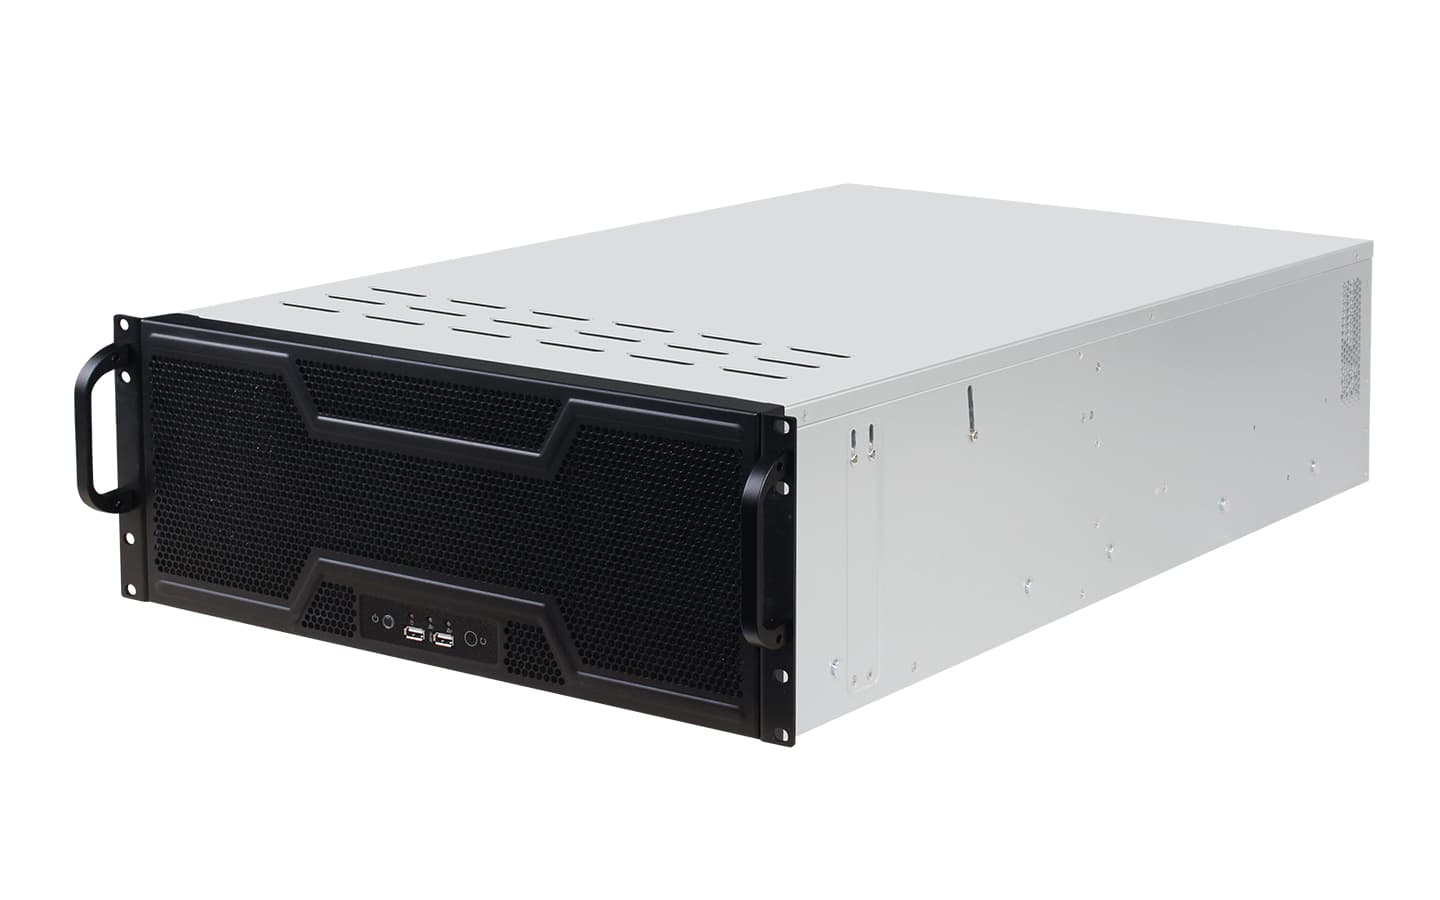
IWILL G4835-P4
4U GPU/AI сървърно шаси с поддръжка на 5 GPU.
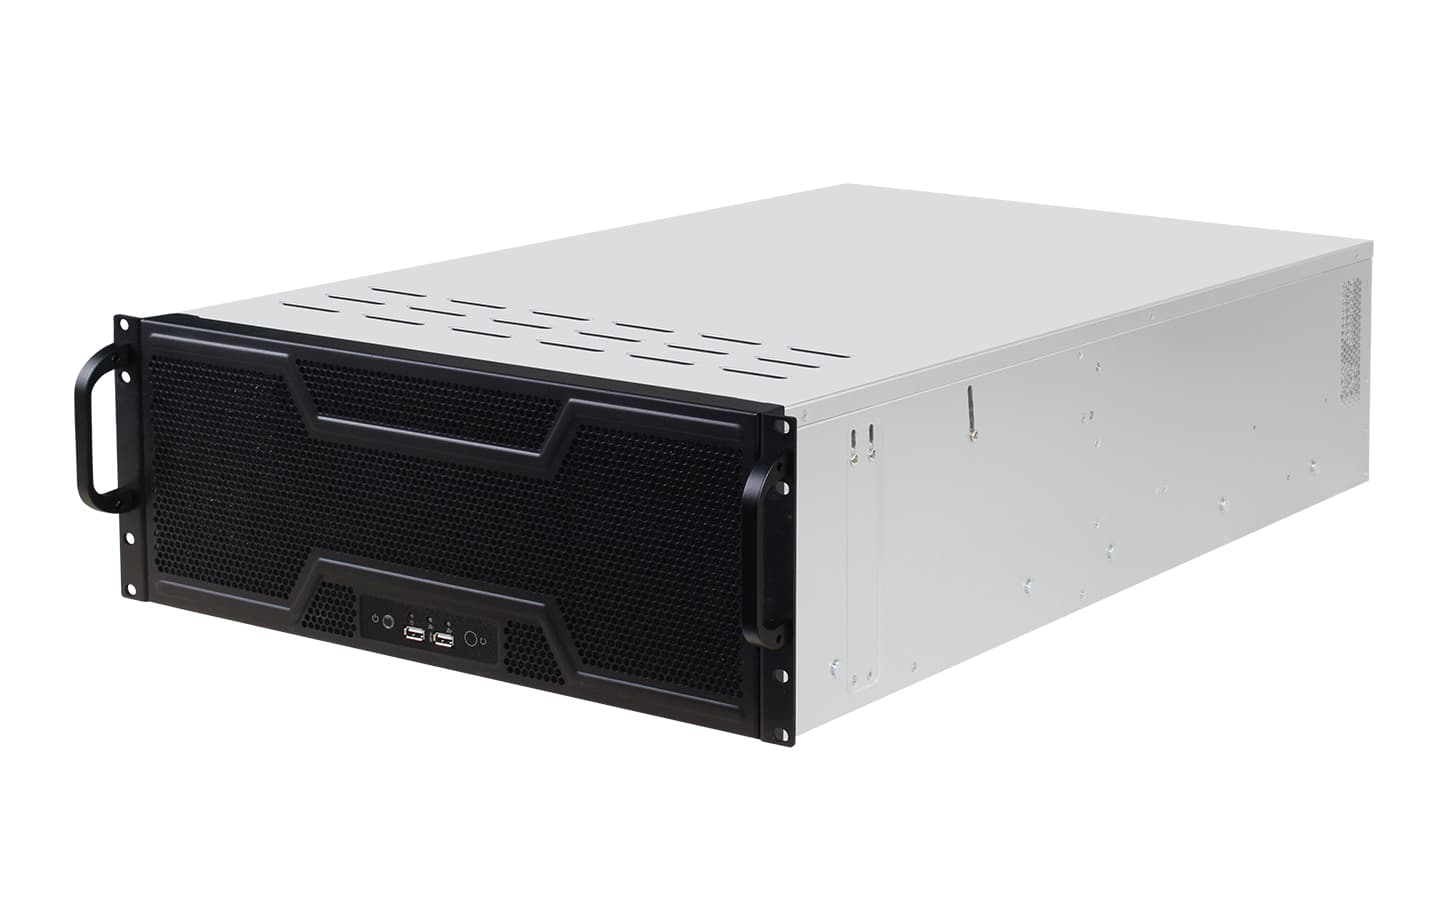
IWILL G4830-P4
4U GPU/AI сървърно шаси с поддръжка на 10 GPU.
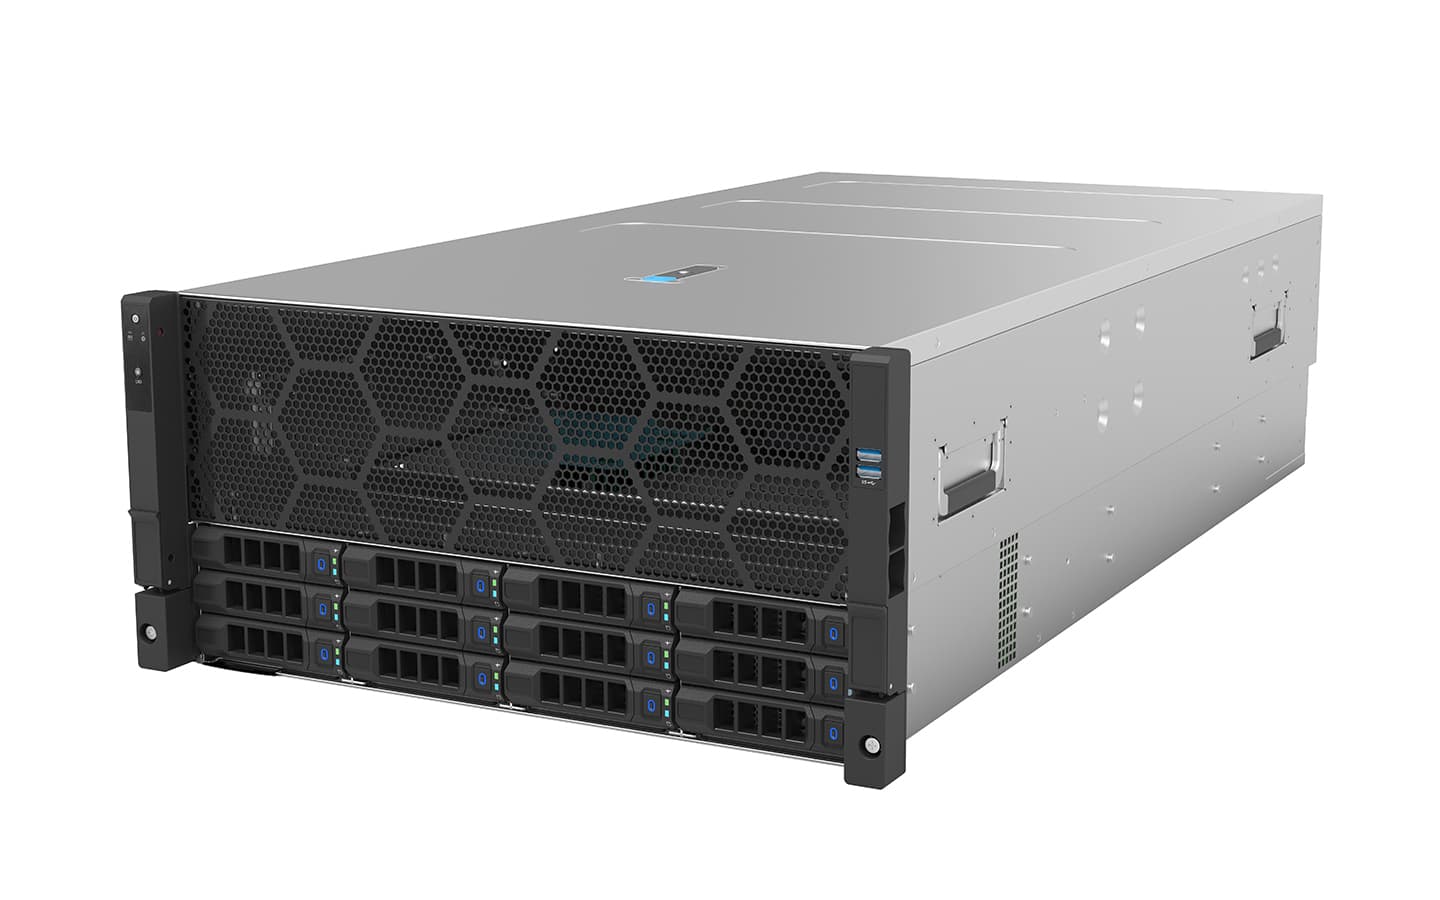
IWILL F-G587-H12-A8
5U GPU/AI сървърно шаси (barebone) с поддръжка на 8 GPU.
Пълната гама включва 15 модела GPU/AI шасита — от 4U с 5 карти до 9U с 10 карти, със и без дискови масиви. Вижте всички GPU/AI сървърни шасита или цялата серия сървърни и сторидж шасита.
Чеклист преди запитване
Отговорите на тези седем въпроса определят конфигурацията почти изцяло. Ако ги носите наготово, оферта се прави в рамките на деня.
- 01
Инференция, обучение или и двете?
Определя изискването за памет и дали един сървър стига.
- 02
Кои модели ще ползвате и в каква квантизация?
От това следва нужната обща VRAM.
- 03
Колко карти днес и колко след две години?
Шасито се избира по втората цифра, не по първата.
- 04
Кой конкретен модел карта — ширина и дължина?
Решава кое шаси изобщо ги приема.
- 05
Данните за обучение живеят ли в сървъра?
Ако да, търсите модел с дискови позиции като G465-12.
- 06
Има ли кой да обслужва машината на място?
Ако не — barebone с BMC.
- 07
Каква е наличната мощност и климатизация в стаята?
Определя дали въздушното охлаждане е достатъчно.
Често задавани въпроси
Кога локалният GPU сървър се изплаща спрямо облачни GPU часове?
Колко GPU карти са ми нужни, за да пусна голям езиков модел локално?
Каква е разликата между 4U, 5U, 7U и 9U шаси за GPU сървър?
Какво е CRPS захранване и защо резервирането е важно?
Кога е нужно течно охлаждане вместо вентилатори?
Мога ли да ползвам обикновени геймърски видеокарти в сървърно шаси?
Как се управлява такъв сървър дистанционно?
Планирате собствен AI сървър?
Официален дистрибутор IWILL за България — помагаме с избора на шаси според картите, които ще ползвате, наличната мощност и дълбочината на rack-а. Конфигурация, наличност и цена се потвърждават с конкретна оферта.